Integração Estratégica: Bancos de Dados AWS na Vercel
Desde dezembro de 2025, a AWS disponibilizou seus bancos de dados no Marketplace da Vercel, marcando um passo importante na simplificação da infraestrutura para desenvolvedores. Agora é possível criar e conectar instâncias de Amazon Aurora PostgreSQL, Amazon Aurora DSQL e Amazon DynamoDB diretamente do dashboard da Vercel, sem necessidade de configurações complexas.
Como Começar
Para iniciar, desenvolvedores podem criar uma nova conta AWS diretamente pela Vercel, que já inclui acesso aos três serviços de banco de dados mencionados. A promoção oferece $100 USD em créditos que podem ser utilizados em qualquer uma das opções de banco de dados por até seis meses, reduzindo significativamente as barreiras de entrada para prototipagem e desenvolvimento.
Configuração Rápida e Produção Imediata
Uma vez que a conta está configurada, é possível ter um banco de dados Aurora pronto para produção ou uma tabela DynamoDB alimentando seus projetos Vercel em questão de segundos. Todo o gerenciamento — desde o plano escolhido até a adição de informações de pagamento e visualização de uso — pode ser feito no portal de configurações AWS acessível diretamente do dashboard da Vercel.
Capacidades e Vantagens Técnicas
A integração oferece opções serverless para Aurora PostgreSQL, Aurora DSQL e DynamoDB, simplificando as necessidades das aplicações e reduzindo custos através do dimensionamento automático para zero quando não há uso. Essa abordagem elimina a cobrança por recursos ociosos, tornando a solução especialmente atrativa para aplicações com padrões de consumo variáveis.
Cobertura Geográfica e Escalabilidade
Os bancos de dados podem ser criados em Regiões AWS estratégicas: US East (Virgínia do Norte), US East (Ohio), US West (Oregon), Europe (Irlanda), Europe (Frankfurt), Ásia Pacífico (Tóquio) e Ásia Pacífico (Mumbai). Novos locais estão previstos para o futuro, ampliando a disponibilidade para diferentes contextos geográficos.
Segurança e Confiabilidade
Os bancos de dados AWS entregam segurança, confiabilidade e eficiência de custo sem a sobrecarga operacional associada ao gerenciamento manual de infraestrutura. A abordagem é adequada tanto para desenvolvedores prototipando suas próximas ideias quanto para equipes mantendo aplicações de produção críticas e orientadas por dados ou inteligência artificial.
O Desafio do Rastreamento de Experimentos em Ambientes Distribuídos
Cientistas de dados frequentemente conduzem experimentos de machine learning em ambientes de dados diversos, como o Snowflake, utilizando a biblioteca Snowpark. No entanto, rastrear esses experimentos de forma centralizada apresenta desafios significativos. Manter um repositório único que monitore metadados de experimentos, parâmetros, hiperparâmetros, modelos, resultados e outras informações relevantes torna-se complexo quando esses processos ocorrem em plataformas distintas.
A AWS apresenta uma solução: integrar o MLflow gerenciado do SageMaker como repositório central para registro desses experimentos, estabelecendo um sistema unificado de monitoramento de progresso.
Capacidades do MLflow Gerenciado no SageMaker
O MLflow gerenciado da AWS oferece serviços totalmente gerenciados para rastreamento de experimentos, empacotamento de modelos e registro de modelos. O Registro de Modelos do SageMaker simplifica o versionamento e a implantação de modelos, facilitando transições suaves do desenvolvimento para produção.
Padronização de fluxos de trabalho de machine learning em toda a organização
Melhoria na colaboração entre equipes de ciência de dados
Aceleração da adoção de IA/ML com infraestrutura mais segura e escalável
Arquitetura da Solução: Snowpark Integrado ao MLflow
A integração entre Snowflake e SageMaker permite um fluxo de trabalho coeso. O Snowpark para Python funciona como biblioteca do lado cliente, permitindo que código Python interaja com o Snowflake a partir de kernels Python, como os notebooks Jupyter do SageMaker.
Um fluxo de trabalho típico inclui preparação de dados no Snowflake, juntamente com engenharia de características e treinamento de modelos dentro do Snowpark. Posteriormente, o MLflow gerenciado do SageMaker é utilizado para rastreamento de experimentos e registro de modelos, integrados às capacidades do SageMaker. Essa abordagem permite que cientistas de dados executem transformações e engenharia de características no Snowflake e aproveitem a infraestrutura gerenciada do SageMaker para treinamento e implantação, facilitando orquestração de fluxos de trabalho mais suave e tratamento seguro dos dados.
Rastreamento Centralizado com MLflow
O rastreamento MLflow é fundamental nessa integração entre SageMaker, Snowpark e Snowflake, pois fornece um ambiente centralizado para registro e gerenciamento de todo o ciclo de vida do machine learning. Enquanto o Snowpark processa dados do Snowflake e treina modelos, o Rastreamento MLflow captura detalhes essenciais:
Parâmetros e hiperparâmetros do modelo
Métricas de desempenho
Artefatos gerados durante o treinamento
Isso permite que cientistas de dados monitorem experimentos, comparem diferentes versões de modelos e verifiquem reprodutibilidade. Com as capacidades de versionamento e registro do MLflow, equipes podem rastrear resultados até o conjunto de dados específico e as transformações utilizadas, tornando mais simples monitorar o desempenho de modelos ao longo do tempo e manter um fluxo de trabalho de machine learning transparente e eficiente.
Essa abordagem oferece diversos benefícios práticos: fornece um rastreador MLflow escalável e gerenciado no SageMaker, enquanto aproveita as capacidades de processamento do Snowpark para inferência de modelo dentro do ambiente Snowflake, criando um sistema unificado de dados. O fluxo de trabalho permanece dentro do ambiente Snowflake, o que aprimora segurança e governança dos dados. Adicionalmente, reduz custos ao utilizar a potência de computação elástica do Snowflake para inferência sem necessidade de manter infraestrutura separada para servir modelos.
Pré-requisitos para Implementação
Antes de estabelecer o MLflow do SageMaker, é necessário criar e configurar os seguintes recursos:
Após uma execução bem-sucedida, os experimentos podem ser rastreados no MLflow do SageMaker. Clicando no nome da execução (“Run name”), é possível acessar insights detalhados sobre cada experimento.
Limpeza de Recursos
Para evitar custos contínuos, execute estas etapas para remover os recursos configurados:
Delete a conta SageMaker Studio (isso também deleta o servidor de rastreamento MLflow)
A integração entre o MLflow gerenciado do SageMaker e o Snowflake oferece uma solução abrangente para gerenciar o ciclo de vida completo do machine learning. Ao aproveitar o Snowpark, a solução aprimora ainda mais esse conjunto de capacidades, permitindo fluxos de trabalho mais suaves de processamento de dados e implantação de modelos.
Para começar, siga as instruções passo a passo fornecidas acima para configurar o Servidor de Rastreamento MLflow no SageMaker Studio e integrá-lo com o Snowflake. Lembre-se de implementar as práticas recomendadas de segurança da AWS, incluindo funções e permissões apropriadas de Gerenciamento de Identidade e Acesso, e garantindo que todas as credenciais sejam protegidas adequadamente. Os exemplos de código e instruções neste artigo servem como ponto de partida — podem ser adaptados para casos de uso e requisitos específicos enquanto se mantêm as práticas recomendadas de segurança e escalabilidade.
Conteúdo de mídia, entretenimento, publicidade, educação e treinamento corporativo combinam elementos visuais, sonoros e de movimento para contar histórias e transmitir informações. Essa complexidade multidimensional supera em muito a simplicidade do texto, onde palavras individuais possuem significados bem definidos. Para sistemas de IA, essa riqueza de informação representa um desafio considerável.
Um vídeo típico integra diversos elementos simultaneamente: componentes visuais como cenas, objetos e ações; dinâmica temporal expressa através de movimento e transições; elementos de áudio incluindo diálogos, música e efeitos sonoros; além de textos sobrepostos como legendas e capturas. Essa multiplicidade de camadas de informação cria desafios significativos para organizações que precisam buscar em arquivos de vídeo, localizar cenas específicas, categorizar automaticamente e extrair insights de seus ativos de mídia para tomada de decisão efetiva.
Abordagem Multimodal com Embeddings Especializados
A solução apresentada pela AWS com o TwelveLabs Marengo utiliza uma arquitetura de múltiplos vetores para criar representações especializadas de diferentes modalidades de conteúdo. Em vez de comprimir toda a informação em um único vetor — abordagem que resulta em perda considerável de nuances — o modelo gera embeddings distintos para cada aspecto do vídeo.
Embeddings são representações vetoriais densas que capturam significado semântico em um espaço de alta dimensionalidade. Funcionam como impressões digitais numéricas que codificam a essência do conteúdo de forma compreensível e comparável por máquinas. Para texto, um embedding pode capturar que “rei” e “rainha” são conceitos relacionados; para imagens, pode compreender que um retriever dourado e um labrador são ambos cães, apesar de aparências diferentes.
A arquitetura multivetor do Marengo 3.0 oferece vantagens significativas: cada vetor captura uma modalidade específica, evitando perda de informação; permite buscas flexíveis direcionadas a aspectos particulares do conteúdo — somente visual, apenas áudio ou combinadas; e proporciona precisão superior em cenários complexos enquanto mantém escalabilidade eficiente para grandes volumes de dados videoconteúdo em empresas.
Integração com Amazon Bedrock e OpenSearch Serverless
A AWS expandiu as capacidades do Amazon Bedrock para suportar o modelo TwelveLabs Marengo Embed 3.0 com processamento de texto e imagem em tempo real através de inferência síncrona. Essa integração possibilita que negócios implementem funcionalidade de busca em vídeos mais rápida utilizando consultas em linguagem natural, além de viabilizar descoberta interativa de produtos através de sofisticado matching de similaridade de imagens.
Para armazenar e recuperar embeddings, a solução utiliza Amazon OpenSearch Serverless como banco de dados vetorial. Como banco de dados específico para vetores, o OpenSearch Serverless permite localizar conteúdo similar rapidamente através de busca semântica, sem necessidade de gerenciar servidores ou infraestrutura subjacente.
O Amazon Bedrock utiliza API assíncrona para geração de embeddings de vídeo com o modelo Marengo. Um vídeo típico é processado para gerar múltiplas representações vetoriais especializadas:
Embeddings Visuais: capturam elementos visuais do conteúdo
Embeddings de Transcrição: representam texto transcrito do áudio
Embeddings de Áudio: codificam características sonoras do vídeo
Por padrão, um único processamento com o Marengo gera embeddings para visual-texto, visual-imagem e áudio. É possível configurar para gerar apenas tipos específicos de embedding conforme necessário.
O processamento segmenta automaticamente o vídeo em clips. Para vídeo, a divisão ocorre em mudanças naturais de cena (shot boundaries). Para áudio, os segmentos são divididos em durações próximas a 10 segundos — por exemplo, áudio de 50 segundos resulta em 5 segmentos de 10 segundos cada.
Preparando o Ambiente
Antes de começar a implementação, é necessário verificar alguns pré-requisitos:
Familiaridade básica com bancos de dados vetoriais e embeddings
Para demonstração prática, a solução utiliza Netflix Open Content, conteúdo de código aberto disponível sob licença Creative Commons Attribution 4.0 International. Especificamente, um vídeo chamado Meridian é usado para demonstrar o funcionamento do modelo.
Criando Embeddings de Vídeo
O seguinte fragmento de código Python mostra um exemplo de invocação da API que processa um vídeo armazenado em um bucket S3:
Um vídeo típico processado desta forma gera 280 embeddings individuais — um para cada segmento — viabilizando busca temporal precisa e análise detalhada. A saída inclui embeddings multimodais com estrutura similar a esta:
Após criar uma coleção no OpenSearch Serverless, é necessário criar um índice que contenha propriedades adequadas para armazenar embeddings vetoriais. O seguinte código demonstra essa configuração:
Após gerar os embeddings, é necessário ingeri-los no índice do OpenSearch. O fragmento abaixo demonstra esse processo:
documents = []
for i, segment in enumerate(video_embeddings):
    document = {
        "embedding": segment["embedding"],
        "start_time": segment["startSec"],
        "end_time": segment["endSec"],
        "video_id": video_id,
        "segment_id": i,
        "embedding_option": segment.get("embeddingOption", "visual")
    }
    documents.append(document)

bulk_data = []
for doc in documents:
    bulk_data.append({"index": {"_index": self.index_name}})
    bulk_data.append(doc)

bulk_body = "\n".join(json.dumps(item) for item in bulk_data) + "\n"
response = oss_client.bulk(body=bulk_body, index=self.index_name)
Busca Semântica Cruzada Entre Modalidades
Uma das grandes vantagens do design multivetor do Marengo é permitir buscas cruzadas entre diferentes modalidades — capacidade impossível com modelos de vetor único. Criando embeddings separados mas alinhados para elementos visuais, áudio, movimento e contexto, é possível buscar vídeos utilizando o tipo de entrada que for mais conveniente.
Por exemplo, uma consulta por texto “jazz tocando” retorna clipes de vídeo com músicos em apresentação, faixas de áudio de jazz e cenas de salas de concerto extraídas de uma única consulta textual.
Busca por Texto
O seguinte fragmento demonstra capacidade de busca semântica cruzada utilizando texto:
text_query = "a person smoking in a room"
modelInput={
    "inputType": "text",
    "text": {
        "inputText": text_query
    }
}
response = self.bedrock_client.invoke_model(
    modelId="us.twelvelabs.marengo-embed-3-0-v1:0",
    body=json.dumps(modelInput))
result = json.loads(response["body"].read())
query_embedding = result["data"][0]["embedding"]

search_body = {
    "query": {
        "knn": {
            "embedding": {
                "vector": query_embedding,
                "k": top_k
            }
        }
    },
    "size": top_k,
    "_source": ["start_time", "end_time", "video_id", "segment_id"]
}
response = opensearch_client.search(index=self.index_name, body=search_body)

print(f"\n✅ Found {len(response['hits']['hits'])} matching segments:")
results = []
for hit in response['hits']['hits']:
    result = {
        "score": hit["_score"],
        "video_id": hit["_source"]["video_id"],
        "segment_id": hit["_source"]["segment_id"],
        "start_time": hit["_source"]["start_time"],
        "end_time": hit["_source"]["end_time"]
    }
    results.append(result)
Busca por Imagem
O modelo também suporta busca semântica iniciada a partir de uma imagem. O fragmento seguinte demonstra essa funcionalidade:
Além de buscas textuais e visuais, o modelo Marengo também possibilita buscar vídeos utilizando embeddings de áudio, com foco em diálogo e fala. Essa capacidade permite que usuários localizem vídeos com base em palestrantes específicos, conteúdo de diálogo ou tópicos falados, criando uma experiência de busca abrangente que combina texto, imagem e áudio para compreensão integrada do conteúdo videoconteúdo.
Impacto Prático
A combinação do TwelveLabs Marengo com Amazon Bedrock abre possibilidades significativas para compreensão de vídeos através de sua abordagem multimodal de múltiplos vetores. Uma chamada única à API do Bedrock transformou um arquivo de vídeo em 336 segmentos pesquisáveis capazes de responder a consultas textuais, visuais e de áudio.
Essas capacidades criam oportunidades para descoberta de conteúdo em linguagem natural, gerenciamento simplificado de ativos de mídia e outras aplicações que auxiliam organizações a compreender melhor e utilizar seu acervo de conteúdo videoconteúdo em escala. Conforme vídeo continua dominando experiências digitais, modelos como o Marengo oferecem fundação sólida para construir sistemas de análise de vídeo mais inteligentes.
Explore o código de exemplo e descubra como compreensão de vídeo multimodal pode transformar suas aplicações.
Imagine que sua empresa acaba de colocar em produção seu primeiro aplicativo de IA generativa. Os resultados iniciais são promissores, mas conforme você planeja expandir a solução para outros departamentos, surgem questões críticas: como garantir consistência em políticas de segurança? Como evitar vieses nos modelos? Como manter controle à medida que as aplicações de IA se multiplicam?
A realidade é que muitas organizações enfrentam esses mesmos desafios. Uma pesquisa de líderes empresariais em 38 países envolvendo mais de 750 executivos revelou tanto desafios quanto oportunidades ao construir uma estratégia de governança. Embora as organizações estejam comprometendo recursos significativos — a maioria planeja investir mais de 1 milhão de dólares em IA responsável — obstáculos de implementação persistem. Mais de 50% dos respondentes apontam lacunas de conhecimento como a barreira primária, enquanto 40% citam incerteza regulatória.
Porém, há uma luz no fim do túnel. Empresas com programas estabelecidos de IA responsável relatam benefícios substanciais: 42% observam melhor eficiência operacional, enquanto 34% experimentam aumento de confiança dos consumidores. Esses dados demonstram por que uma gestão robusta de riscos é fundamental para desbloquear todo o potencial da IA.
IA Responsável: Não é Negociável Desde o Primeiro Dia
A AWS, através de seu centro de inovação em IA generativa, tem observado que organizações com resultados mais sólidos incorporam governança em sua essência desde o início. Essa visão alinha-se com o compromisso da AWS com desenvolvimento responsável de IA, evidenciado pelo lançamento recente do framework AWS Well-Architected para IA Responsável, um guia abrangente para implementar práticas responsáveis ao longo de todo o ciclo de vida do desenvolvimento.
O centro de inovação tem aplicado consistentemente esses princípios abraçando uma filosofia de “responsabilidade por design”, delimitando cuidadosamente casos de uso e seguindo orientações validadas cientificamente. Essa abordagem resultou na criação da solução AI Risk Intelligence (AIRI), que transforma essas melhores práticas em controles de governança automatizados e acionáveis — tornando a implementação de IA responsável tanto alcançável quanto escalável.
Quatro Estratégias para Deployments Seguros de IA Generativa
Com base na experiência de ajudar mais de mil organizações em diversos setores e geografias, aqui estão estratégias-chave para integrar controles robustos de governança e segurança no desenvolvimento, revisão e deployment de aplicações de IA através de um processo automatizado e contínuo.
1. Adotar uma Mentalidade de Governança por Design
No centro de inovação, trabalham diariamente com organizações na vanguarda da adoção de IA generativa e agentic. Um padrão consistente emerge: enquanto a promessa da IA generativa seduz líderes de negócios, eles frequentemente enfrentam dificuldades em traçar um caminho rumo a uma implementação responsável e segura. As organizações que alcançam resultados mais impressionantes estabelecem uma mentalidade de governança por design desde o início — tratando gerenciamento de riscos de IA e considerações de IA responsável como elementos fundamentais, não como checkboxes de conformidade.
Essa abordagem transforma governança de uma barreira percebida em uma vantagem estratégica para inovar mais rapidamente, mantendo controles apropriados. Ao incorporar governança no próprio processo de desenvolvimento, essas organizações conseguem escalar suas iniciativas de IA com maior confiança e segurança.
2. Alinhar Tecnologia, Negócios e Governança
A missão principal do centro de inovação é ajudar clientes a desenvolver e implementar soluções de IA que atendam às necessidades empresariais, aproveitando otimamente os serviços da AWS. Porém, exploração técnica deve caminhar lado a lado com planejamento de governança. Pense nisto como coordenar uma orquestra — você não dirigiria uma sinfonia sem compreender como cada instrumento funciona e como harmonizam juntos. Similarmente, uma governança efetiva de IA exige compreensão profunda da tecnologia subjacente antes de implementar controles.
O centro ajuda organizações a estabelecer conexões claras entre capacidades tecnológicas, objetivos de negócios e requisitos de governança desde o início, garantindo que esses três elementos trabalhem em conjunto.
3. Integrar Segurança como Base da Governança
Após estabelecer uma mentalidade de governança por design e alinhar objetivos de negócios, tecnologia e governança, o próximo passo crucial é a implementação. A experiência mostra que segurança serve como o ponto de entrada mais efetivo para operacionalizar governança abrangente de IA. Segurança não apenas oferece proteção vital, mas também suporta inovação responsável construindo confiança na fundação de sistemas de IA.
A abordagem enfatizada pelo centro de inovação privilegia segurança-por-design ao longo de toda a jornada de implementação, desde proteção básica de infraestrutura até detecção sofisticada de ameaças em workflows complexos. Para suportar essa abordagem, a AWS oferece capacidades como o AWS Security Agent, que automatiza validação de segurança ao longo do ciclo de vida do desenvolvimento. Esse agente fronteiriço realiza revisões de segurança customizadas e testes de penetração baseados em padrões definidos centralmente, ajudando organizações a escalar sua expertise em segurança para acompanhar a velocidade de desenvolvimento.
Essa abordagem focada em segurança ancora um conjunto mais amplo de controles de governança. O framework AWS de IA Responsável unifica justiça, explicabilidade, privacidade e segurança, segurança, controlabilidade, veracidade e robustez, governança e transparência em uma abordagem coerente. Conforme sistemas de IA se integram profundamente aos processos empresariais e tomada de decisão autônoma, automatizar esses controles mantendo supervisão rigorosa torna-se crucial para escalar com êxito.
4. Automatizar Governança em Escala Corporativa
Com os elementos fundamentais em lugar — mentalidade, alinhamento e controles de segurança — organizações precisam de um meio para escalar sistematicamente seus esforços de governança. É aqui que a solução AIRI entra. Em vez de criar novos processos, ela operacionaliza os princípios e controles discutidos através de automação, em uma abordagem faseada. A arquitetura da solução integra-se perfeitamente aos workflows existentes através de um processo em três etapas: entrada do usuário, avaliação automatizada e insights acionáveis.
A solução analisa tudo, desde código-fonte até documentação de sistemas, usando técnicas avançadas como processamento automatizado de documentos e avaliações baseadas em modelos de linguagem para conduzir avaliações abrangentes de risco. Mais importante, ela realiza testes dinâmicos de sistemas de IA generativa, verificando consistência semântica e vulnerabilidades potenciais enquanto se adapta aos requisitos específicos de cada organização e padrões industriais.
Da Teoria à Prática
A verdadeira medida de uma governança de IA efetiva é como ela evolui com uma organização mantendo padrões rigorosos em escala. Quando implementada com êxito, governança automatizada permite que times se concentrem em inovação, confiantes de que seus sistemas de IA operam dentro de guardrails apropriados.
Um exemplo compelling vem da colaboração com Ryanair, o maior grupo de companhias aéreas da Europa. Enquanto escalam em direção a 300 milhões de passageiros até 2034, a Ryanair precisava de governança de IA responsável para sua aplicação de tripulação de cabine, que fornece ao pessoal de frente linhas informações operacionais cruciais. Usando Amazon Bedrock, o centro de inovação conduziu uma avaliação alimentada por IA. Isso estabeleceu gerenciamento de risco transparente e baseado em dados onde riscos eram previamente difíceis de quantificar — criando um modelo de governança de IA responsável que a Ryanair agora pode expandir por toda sua carteira de IA.
Essa implementação demonstra o impacto mais amplo de governança sistemática de IA. Organizações usando esse framework reportam consistentemente caminhos acelerados para produção, redução de trabalho manual e capacidades aprimoradas de gerenciamento de risco. Mais importante ainda, alcançaram forte alinhamento entre funções, desde times de tecnologia até legal e segurança — todos trabalhando a partir de objetivos claros e mensuráveis.
Uma Fundação para Inovação
Governança de IA responsável não é uma restrição — é um catalisador. Ao incorporar governança na urdidura do desenvolvimento de IA, organizações podem inovar com confiança, sabendo que possuem controles para escalar segura e responsavelmente. O exemplo acima demonstra como governança automatizada transforma frameworks teóricos em soluções práticas que impulsionam valor comercial mantendo confiança.
Para aprender mais, consulte as informações sobre o centro de inovação em IA generativa da AWS e como estão ajudando organizações de diferentes tamanhos implementar IA responsável para complementar seus objetivos empresariais.
Em dezembro de 2025, a AWS anunciou a abertura de uma nova localização de AWS Direct Connect dentro da CMC Tower em Hanói, Vietnã. Este é o primeiro ponto de presença do serviço Direct Connect no país e marca uma expansão significativa da infraestrutura da AWS na região do Sudeste Asiático.
A partir dessa localização, é possível estabelecer acesso privado e direto a todas as regiões públicas da AWS (com exceção daquelas localizadas na China), ao AWS GovCloud, bem como às AWS Local Zones. Isso abre novas possibilidades para empresas vietnamitas e da região que buscam conectividade otimizada com a infraestrutura de nuvem global da AWS.
Capacidades e Velocidades de Conexão
A localização em Hanói oferece opções de conectividade em múltiplas velocidades. Os clientes podem contratar conexões dedicadas de 1 Gbps, 10 Gbps e 100 Gbps conforme suas necessidades. Para as conexões de maior capacidade (10 Gbps e 100 Gbps), a AWS disponibiliza criptografia MACsec, garantindo camadas adicionais de segurança para dados em trânsito.
Entendendo o AWS Direct Connect
O serviço AWS Direct Connect funciona como um intermediário que estabelece uma conexão física e privada entre a infraestrutura da AWS e os ambientes locais dos clientes — que podem ser datacenters, escritórios ou ambientes de colocação. Diferentemente das conexões convencionais pela internet pública, as conexões via Direct Connect proporcionam uma experiência de rede mais consistente e previsível, com menor latência e maior confiabilidade.
Expansão Global da Rede de Direct Connect
A nova localização em Hanói se integra à rede global da AWS Direct Connect, que agora conta com mais de 149 localizações espalhadas pelo mundo. Essa expansão contínua reflete o compromisso da AWS em trazer conectividade de alta qualidade para regiões emergentes e mercados em crescimento.
Para obter mais informações sobre todas as localizações disponíveis do Direct Connect em todo o mundo, os usuários podem consultar a seção dedicada nos detalhes do produto. Além disso, há um guia de primeiros passos disponível para quem deseja aprender como adquirir e implantar o serviço Direct Connect.
O GuardDuty Extended Threat Detection conseguiu correlacionar sinais em múltiplas fontes de dados e elevar uma descoberta de sequência de ataque com severidade crítica. Utilizando capacidades avançadas de inteligência de ameaças e mecanismos de detecção existentes, o GuardDuty identificou proativamente essa campanha em andamento e alertou rapidamente os clientes sobre a ameaça.
A Amazon Web Services (AWS) está compartilhando descobertas relevantes e orientação de mitigação para ajudar clientes a tomar medidas apropriadas. É importante notar que essas ações não exploram uma vulnerabilidade em um serviço AWS, mas exigem credenciais válidas que um usuário não autorizado utiliza de forma indevida. Embora essas ações ocorram no domínio do cliente do modelo de responsabilidade compartilhada, a AWS recomenda passos que clientes podem adotar para detectar, prevenir ou reduzir o impacto dessa atividade.
Entendendo a campanha de mineração
A campanha de mineração de criptomoedas detectada recentemente empregou uma técnica inovadora de persistência projetada para interromper a resposta a incidentes e estender operações de mineração. A campanha contínua foi inicialmente identificada quando engenheiros de segurança do GuardDuty descobriram técnicas de ataque semelhantes sendo usadas em múltiplas contas de clientes AWS, indicando uma campanha coordenada visando clientes que usam credenciais IAM comprometidas.
Operando a partir de um provedor de hospedagem externo, o ator de ameaça rapidamente enumerou quotas de serviço do Amazon EC2 e permissões de IAM antes de implantar recursos de mineração em EC2 e ECS. Dentro de 10 minutos após o ator de ameaça obter acesso inicial, mineradores de criptomoedas estavam operacionais.
Uma técnica chave observada nesse ataque foi o uso de ModifyInstanceAttribute com desativação de terminação de API definida como verdadeira, forçando as vítimas a reativar a terminação de API antes de excluir os recursos impactados. Desabilitar proteção de terminação de instância adiciona considerações extra para capacidades de resposta a incidentes e pode interromper controles de remediação automatizados.
O uso scripted do ator de ameaça de múltiplos serviços de computação, combinado com técnicas de persistência emergentes, representa um avanço nas metodologias de persistência de mineração de criptomoedas que equipes de segurança devem estar cientes. As múltiplas capacidades de detecção do GuardDuty identificaram com sucesso a atividade maliciosa através de inteligência de ameaças de domínio/IP do EC2, detecção de anomalias e sequências de ataque EC2 do Extended Threat Detection. O GuardDuty Extended Threat Detection conseguiu correlacionar sinais como uma descoberta AttackSequence:EC2/CompromisedInstanceGroup.
Indicadores de compromisso
Equipes de segurança devem monitorar os seguintes indicadores para identificar essa campanha de mineração de criptomoedas. Como atores de ameaça frequentemente modificam suas táticas e técnicas, esses indicadores podem evoluir ao longo do tempo:
Imagem de contêiner maliciosa: A imagem Docker Hub yenik65958/secret, criada em 29 de outubro de 2025, com mais de 100.000 pulls, foi usada para implantar mineradores de criptomoedas em ambientes containerizados. Essa imagem maliciosa continha um binário SBRMiner-MULTI para mineração de criptomoedas. Essa imagem específica foi removida do Docker Hub, mas atores de ameaça podem implantar imagens semelhantes sob nomes diferentes.
Automação e ferramentas: Padrões de user agent do AWS SDK for Python (Boto3) indicando scripts de automação baseados em Python foram usados em toda a cadeia de ataque.
Domínios de mineração de criptomoedas: asia[.]rplant[.]xyz, eu[.]rplant[.]xyz e na[.]rplant[.]xyz.
Padrões de nomenclatura de infraestrutura: Grupos de auto scaling seguiam convenções de nomes específicas: SPOT-us-east-1-G*-* para instâncias spot e OD-us-east-1-G*-* para instâncias on-demand, onde G indica o número do grupo.
Análise da cadeia de ataque
A campanha de mineração de criptomoedas seguiu uma progressão de ataque sistemática em múltiplas fases.
O ataque começou com credenciais de usuário IAM comprometidas possuindo privilégios tipo administrador a partir de uma rede e localização anômala, acionando descobertas de detecção de anomalias do GuardDuty. Durante a fase de descoberta, o atacante sistematicamente explorou ambientes AWS do cliente para entender quais recursos poderia implantar. Eles verificaram quotas de serviço do Amazon EC2 (GetServiceQuota) para determinar quantas instâncias podiam lançar, depois testaram suas permissões chamando a API RunInstances múltiplas vezes com a flag DryRun habilitada.
A flag DryRun foi uma tática de reconhecimento deliberada que permitiu ao ator validar suas permissões de IAM sem realmente lançar instâncias, evitando custos e reduzindo sua pegada de detecção. Essa técnica demonstra que o ator de ameaça estava validando sua capacidade de implantar infraestrutura de mineração de criptomoedas antes de agir. Organizações que não usam tipicamente flags DryRun em seus ambientes devem considerar monitorar esse padrão de API como um indicador de aviso antecipado de compromisso.
O ator de ameaça chamou duas APIs para criar roles de IAM como parte de sua infraestrutura de ataque: CreateServiceLinkedRole para criar uma role para grupos de auto scaling e CreateRole para criar uma role para AWS Lambda. Eles então anexaram a política AWSLambdaBasicExecutionRole à role Lambda. Essas duas roles foram integrais aos estágios de impacto e persistência do ataque.
Impacto no Amazon ECS
O ator de ameaça primeiro criou dezenas de clusters ECS em todo o ambiente, às vezes excedendo 50 clusters ECS em um único ataque. Depois chamou RegisterTaskDefinition com uma imagem Docker Hub maliciosa yenik65958/secret:user. Com a mesma string usada para criação de cluster, o ator então criou um serviço, usando a definição de tarefa para iniciar mineração de criptomoedas em nós AWS Fargate de ECS.
O seguinte é um exemplo de parâmetros de solicitação de API para RegisterTaskDefinition com alocação máxima de CPU de 16.384 unidades:
A imagem maliciosa (yenik65958/secret:user) foi configurada para executar run.sh após ser implantada. O run.sh executa mineração com algoritmo randomvirel usando pools de mineração: asia|eu|na[.]rplant[.]xyz:17155. A flag nproc –all indica que o script deve usar todos os núcleos de processador.
Impacto no Amazon EC2
O ator criou dois templates de lançamento (CreateLaunchTemplate) e 14 grupos de auto scaling (CreateAutoScalingGroup) configurados com parâmetros de scaling agressivos, incluindo tamanho máximo de 999 instâncias e capacidade desejada de 20.
O seguinte é um exemplo de parâmetros de solicitação de CreateLaunchTemplate mostrando UserData sendo fornecido, instruindo as instâncias a começar mineração de criptomoedas:
O ator de ameaça criou grupos de auto scaling usando tanto Instâncias Spot quanto On-Demand para aproveitar quotas de serviço do Amazon EC2 e maximizar consumo de recursos. Os grupos Spot Instance direcionaram instâncias de GPU e aprendizado de máquina (ML) de alto desempenho (g4dn, g5, g5, p3, p4d, inf1), configuradas com alocação on-demand de 0% e estratégia otimizada para capacidade, definidas para escalar de 20 a 999 instâncias.
Os grupos On-Demand Instance direcionaram instâncias de computação, memória e uso geral (c5, c6i, r5, r5n, m5a, m5, m5n), configurados com alocação on-demand de 100%, também definidos para escalar de 20 a 999 instâncias. Após esgotar quotas de auto scaling, o ator lançou diretamente instâncias EC2 adicionais usando RunInstances para consumir a quota de instância EC2 restante.
Persistência
Uma técnica interessante observada nessa campanha foi o uso do ator de ameaça de ModifyInstanceAttribute em todas as instâncias EC2 lançadas para desabilitar terminação de API. Embora proteção de terminação de instância previna terminação acidental da instância, isso adiciona considerações extras para capacidades de resposta a incidentes e pode interromper controles de remediação automatizados.
O seguinte exemplo mostra parâmetros de solicitação de API para ModifyInstanceAttribute:
Após todas as cargas de trabalho de mineração serem implantadas, o ator criou uma função Lambda com configuração que desvia autenticação de IAM e cria um endpoint Lambda público. O ator de ameaça então adicionou uma permissão à função Lambda que permite ao principal invocar a função. Os seguintes exemplos mostram parâmetros de solicitação CreateFunctionUrlConfig e AddPermission:
Para prevenir criação de URLs Lambda públicas, organizações podem implantar políticas de controle de serviço (SCPs) que negam criação ou atualização de URLs Lambda com AuthType de “NONE”:
A abordagem multilayer de detecção do GuardDuty provou ser altamente eficaz na identificação de todos os estágios da cadeia de ataque usando inteligência de ameaças, detecção de anomalias e as capacidades recentemente lançadas de Extended Threat Detection para EC2 e ECS.
Você pode habilitar o plano de proteção foundational do GuardDuty para receber alertas sobre campanhas de mineração de criptomoedas como a descrita neste artigo. Para potencializar ainda mais as capacidades de detecção, recomenda-se fortemente habilitar GuardDuty Runtime Monitoring, que estenderá cobertura de descobertas para eventos de nível de sistema em Amazon EC2, Amazon ECS e Amazon Elastic Kubernetes Service (Amazon EKS).
Descobertas do GuardDuty para EC2
Descobertas de inteligência de ameaças para Amazon EC2 fazem parte do plano de proteção foundational do GuardDuty, que alertará sobre comportamentos de rede suspeitos envolvendo suas instâncias. Esses comportamentos podem incluir tentativas de força bruta, conexões com domínios maliciosos ou de criptografia e outros comportamentos suspeitos. Usando inteligência de ameaças de terceiros e inteligência de ameaças interna, incluindo defesa ativa de ameaças e MadPot, o GuardDuty fornece detecção sobre os indicadores neste artigo através das seguintes descobertas: CryptoCurrency:EC2/BitcoinTool.B e CryptoCurrency:EC2/BitcoinTool.B!DNS.
Descobertas do GuardDuty para IAM
As descobertas IAMUser/AnomalousBehavior abrangendo múltiplas categorias de tática (PrivilegeEscalation, Impact, Discovery) demonstram a capacidade de aprendizado de máquina do GuardDuty em detectar desvios do comportamento normal do usuário. No incidente descrito neste artigo, as credenciais comprometidas foram detectadas porque o ator de ameaça as usou a partir de uma rede e localização anômala e chamou APIs que eram incomuns para as contas.
Runtime Monitoring do GuardDuty
O GuardDuty Runtime Monitoring é um componente importante para correlação de sequência de ataque Extended Threat Detection. O Runtime Monitoring fornece sinais de nível de host, como visibilidade do sistema operacional, e estende cobertura de detecção analisando logs de nível de sistema indicando execução de processo malicioso a nível de host e contêiner, incluindo execução de programas de mineração de criptomoedas em suas cargas de trabalho.
Lançado na re:Invent 2025, a descoberta AttackSequence:EC2/CompromisedInstanceGroup representa uma das mais recentes capacidades Extended Threat Detection no GuardDuty. Esse recurso usa algoritmos de inteligência artificial e aprendizado de máquina para correlacionar automaticamente sinais de segurança em múltiplas fontes de dados a fim de detectar padrões de ataque sofisticados de grupos de recursos de EC2. Embora AttackSequences para EC2 estejam incluídas no plano de proteção foundational do GuardDuty, recomenda-se fortemente habilitar Runtime Monitoring. O Runtime Monitoring fornece insights e sinais chave de ambientes de computação, possibilitando detecção de atividades suspeitas de nível de host e melhorando correlação de sequências de ataque. Para sequências de ataque AttackSequence:ECS/CompromisedCluster, Runtime Monitoring é obrigatório para correlacionar atividade de nível de contêiner.
Recomendações de monitoramento e remediação
Para proteger contra ataques semelhantes de mineração de criptomoedas, clientes AWS devem priorizar controles fortes de gestão de identidade e acesso. Implemente credenciais temporárias em vez de chaves de acesso de longa duração, aplique autenticação multifator (MFA) para todos os usuários e aplique privilégio mínimo aos principais de IAM limitando acesso apenas às permissões necessárias.
Você pode usar AWS CloudTrail para registrar eventos em serviços AWS e consolidar logs em uma única conta para disponibilizá-los às equipes de segurança acessarem e monitorarem. Para saber mais, consulte Recebendo arquivos de log CloudTrail de múltiplas contas na documentação do CloudTrail.
Confirme que o GuardDuty está habilitado em todas as contas e regiões com Runtime Monitoring habilitado para cobertura abrangente. Integre o GuardDuty com AWS Security Hub e Amazon EventBridge ou ferramentas de terceiros para habilitar fluxos de trabalho de resposta automatizados e remediação rápida de descobertas de alta severidade. Implemente controles de segurança de contêiner, incluindo políticas de varredura de imagem e monitoramento para solicitações de alocação de CPU incomuns em definições de tarefa ECS. Finalmente, estabeleça procedimentos específicos de resposta a incidentes para ataques de mineração de criptomoedas, incluindo passos documentados para lidar com instâncias com terminação de API desabilitada—uma técnica usada por esse atacante para complicar esforços de remediação.
Colaboração em tempo real para resposta a incidentes
A AWS Security Incident Response agora oferece integração com o Slack, a plataforma colaborativa baseada em nuvem amplamente utilizada por times de tecnologia. Essa integração possibilita que equipes de segurança se preparem, respondam e se recuperem de eventos de segurança de maneira mais ágil e eficiente, mantendo os fluxos de notificação e comunicação já existentes nas organizações.
Funcionalidades da integração bidirecional
A integração oferece sincronização bidirecional completa: os times podem criar e atualizar casos tanto no console do Security Incident Response quanto no Slack, com replicação automática de dados entre as plataformas. Cada caso de incidente de segurança é representado como um canal dedicado no Slack, enquanto comentários e anexos são sincronizados instantaneamente.
Essa abordagem garante que os responders tenham acesso imediato às informações críticas do caso e possibilita colaboração mais eficiente, independentemente da ferramenta que cada membro do time prefira utilizar. A integração facilita o engajamento mais rápido dos times de segurança, acelerando os tempos de resposta ao adicionar automaticamente os observadores do Security Incident Response ao canal correspondente no Slack.
Arquitetura modular e extensibilidade
A solução está disponível como código aberto no repositório GitHub, permitindo que clientes e parceiros personalizem e estendam a funcionalidade conforme suas necessidades específicas. A integração utiliza o EventBridge, o que possibilita que as organizações continuem usando suas ferramentas existentes de gerenciamento de incidentes de segurança e notificações, enquanto aproveitam as capacidades do AWS Security Incident Response.
Graças à arquitetura modular, há também orientações sobre como utilizar assistentes de Inteligência Artificial, como o Amazon Q Developer ou similares, que facilitam a adição de novos alvos de integração além do Slack.
Como começar
Para iniciar o uso da integração do Security Incident Response com Slack, as organizações podem acessar o repositório GitHub da AWS. A documentação técnica para Slack fornece detalhes de implementação, enquanto o Guia do Usuário do serviço oferece informações completas sobre o AWS Security Incident Response.
A AWS anunciou uma melhoria importante no serviço Artifact: agora é possível acessar diretamente versões anteriores de relatórios de conformidade sem necessidade de contatar o suporte ou representantes da conta. Esse recurso de autoatendimento foi desenvolvido para ajudar clientes a gerenciar de forma mais eficiente sua documentação de conformidade, especialmente em momentos críticos como auditorias e avaliações de fornecedores, quando é frequente a necessidade de apresentar evidências históricas de conformidade.
Como acessar as versões anteriores
Para utilizar esse novo recurso, é necessário contar com a permissão IAM artifact:ListReportVersions, que já está incluída na política gerenciada AWSArtifactReportsReadOnlyAccess. Se você não conseguir visualizar versões anteriores de relatórios no console do Artifact, será necessário entrar em contato com o administrador da sua conta AWS para solicitar essa permissão.
Uma vez autorizado, o processo é simples: acesse o console do Artifact, navegue até a página de relatórios e selecione qualquer relatório para visualizar suas versões disponíveis. Você poderá consultar relatórios de conformidade anteriores, como SOC, ISO e C5.
Disponibilidade e cobertura histórica
A disponibilidade de versões anteriores varia conforme o programa de conformidade. Alguns relatórios oferecem histórico de vários anos anteriores, enquanto outros possuem cobertura histórica mais limitada. O recurso está disponível, no momento, nas regiões US East (N. Virginia) e AWS GovCloud (US-West).
Implementação prática
Para organizações que conduzem avaliações periódicas de conformidade, essa funcionalidade representa uma redução significativa no tempo administrativo. Em vez de depender de processos manuais ou do suporte técnico para acessar documentação anterior, as equipes agora podem consultar o histórico completo de forma autônoma e imediata através da interface do console.
Próximos passos
Para aprofundar seu conhecimento sobre como acessar versões anteriores de relatórios de conformidade, consulte a documentação técnica do Artifact. Para informações gerais sobre o AWS Artifact, visite a página oficial do serviço.
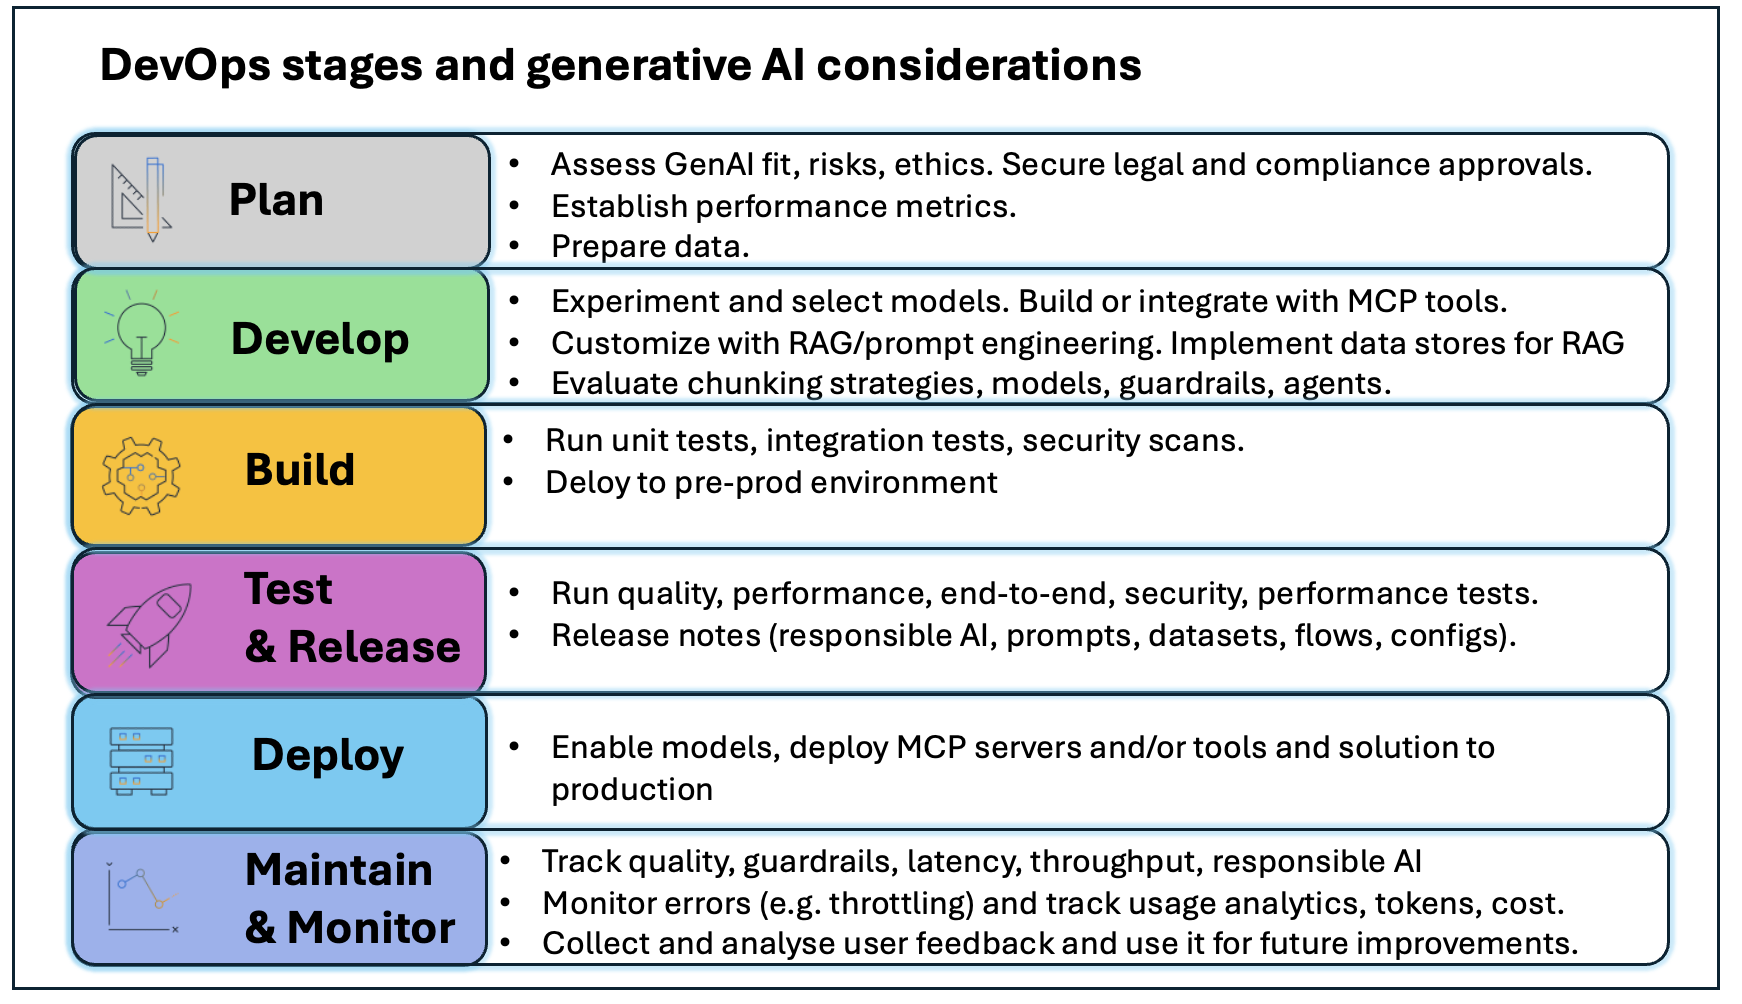
Organizações empresariais estão rapidamente evoluindo de experimentos com IA generativa para implantações em produção e soluções de IA agentic complexas. Esse movimento traz novos desafios em escalabilidade, segurança, governança e eficiência operacional. A série de posts introduz GenAIOps, que aplica princípios de DevOps a soluções de IA generativa, com implementação demonstrada através de aplicações alimentadas pelo Amazon Bedrock, um serviço gerenciado que oferece uma seleção de modelos de fundação (FMs) líderes da indústria.
Por anos, empresas implementaram com sucesso práticas DevOps no ciclo de vida de aplicações, otimizando integração contínua, entrega e implantação de soluções tradicionais. Conforme progridem em sua adoção de IA generativa, descobrem que as práticas DevOps convencionais não são suficientes para gerenciar cargas de IA em escala. Enquanto DevOps tradicional enfatiza colaboração entre equipes e lida com sistemas determinísticos e previsíveis, a natureza não-determinística e probabilística das saídas de IA exige uma abordagem diferente.
Benefícios do GenAIOps
GenAIOps ajuda as organizações em diversos aspectos:
Confiabilidade e mitigação de riscos: Defende contra alucinações, lida com não-determinismo e permite atualizações seguras de modelos com guardrails, pipelines de avaliação e monitoramento automatizado.
Escala e desempenho: Dimensiona para centenas de aplicações mantendo baixa latência e consumo eficiente de custos.
Melhoria contínua e excelência operacional: Constrói ambientes consistentes, reutiliza e versiona ativos de IA generativa, gerencia ciclo de vida de contexto e modelos.
Segurança e conformidade: Robustez em diferentes níveis — modelos, dados, componentes, aplicações e endpoints, abordando ataques de injeção de prompt, vazamento de dados e acesso não autorizado.
Controles de governança: Estabelece políticas claras e responsabilidade sobre dados sensíveis e propriedade intelectual, alinhando com requisitos regulatórios.
Otimização de custos: Otimiza utilização de recursos e gerencia risco de gastos excessivos.
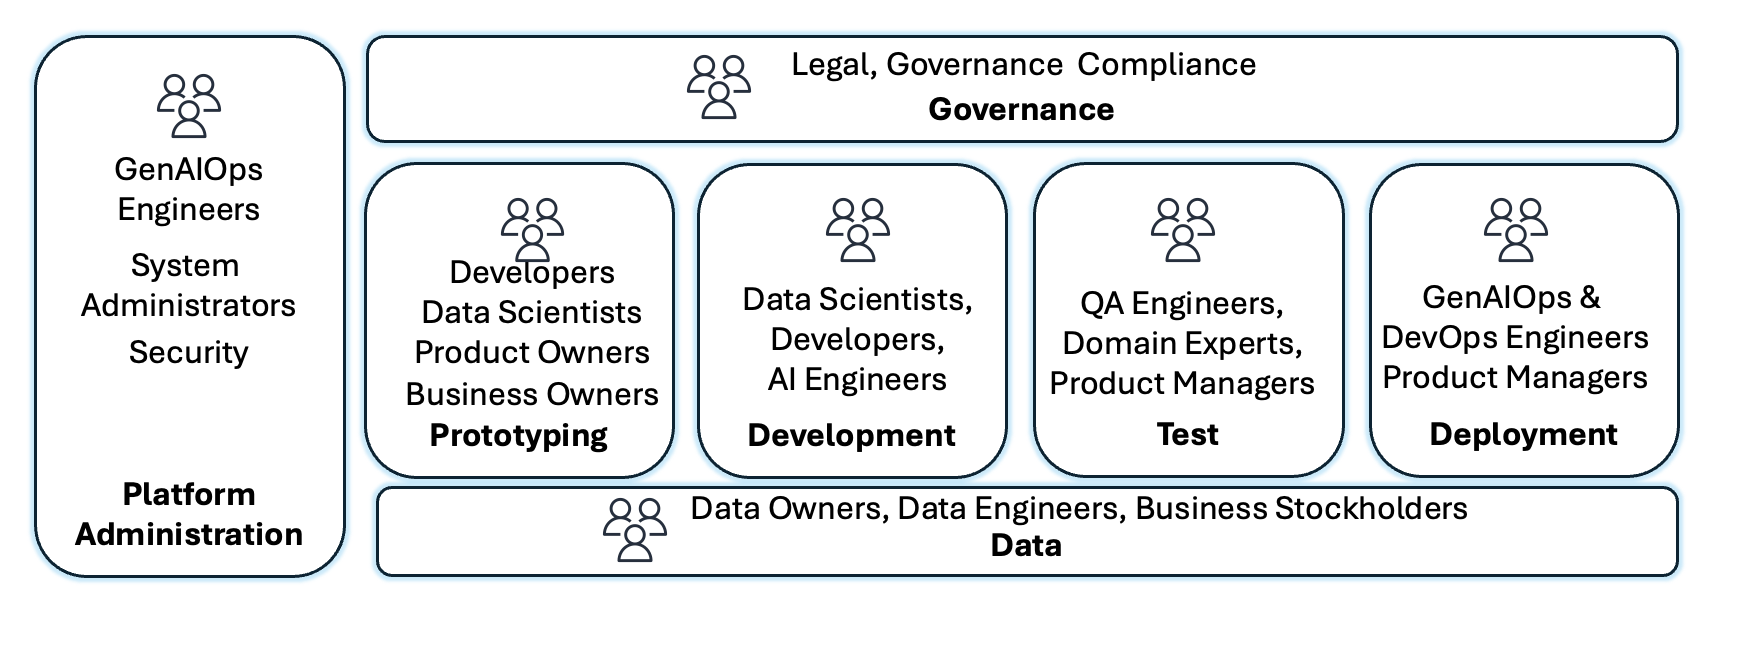
A implementação de GenAIOps expande papéis e processos para enfrentar desafios únicos associados à IA generativa. Proprietários de produto definem e priorizam casos de uso, estabelecem datasets de prompt de referência e validam adequação através de prototipagem rápida. Equipes GenAIOps e de plataforma padronizam infraestrutura de conta e provisionam ambientes para consumo de modelos, personalização, armazenamento de embeddings e orquestração de componentes, configurando pipelines de Integração Contínua/Entrega Contínua (CI/CD) com infraestrutura como código.
Equipes de segurança implementam defesa em profundidade com controles de acesso, protocolos de criptografia e guardrails, monitorando continuamente ameaças emergentes. Especialistas em risco, legal, governança e ética estabelecem frameworks de IA responsável e alcançam alinhamento regulatório. Equipes de dados coletam, preparam e mantêm datasets de alta qualidade. Engenheiros de IA e cientistas de dados desenvolvem código de aplicação, implementam técnicas de engenharia de prompt e constroem fluxos com intervenção humana.
Organizações novas em IA generativa começam com alguns projetos de prova de conceito (POCs) para demonstrar valor. Recursos são limitados e pequenos grupos de adotantes antecipados lideram. Governança é informal, com reuniões espontâneas com equipes legais. A arquitetura DevOps deve servir como baseline, com contas separadas para desenvolvimento, pré-produção e produção, isolamento de ambientes, e controle de custos por ambiente.
Implementação prática em quatro passos
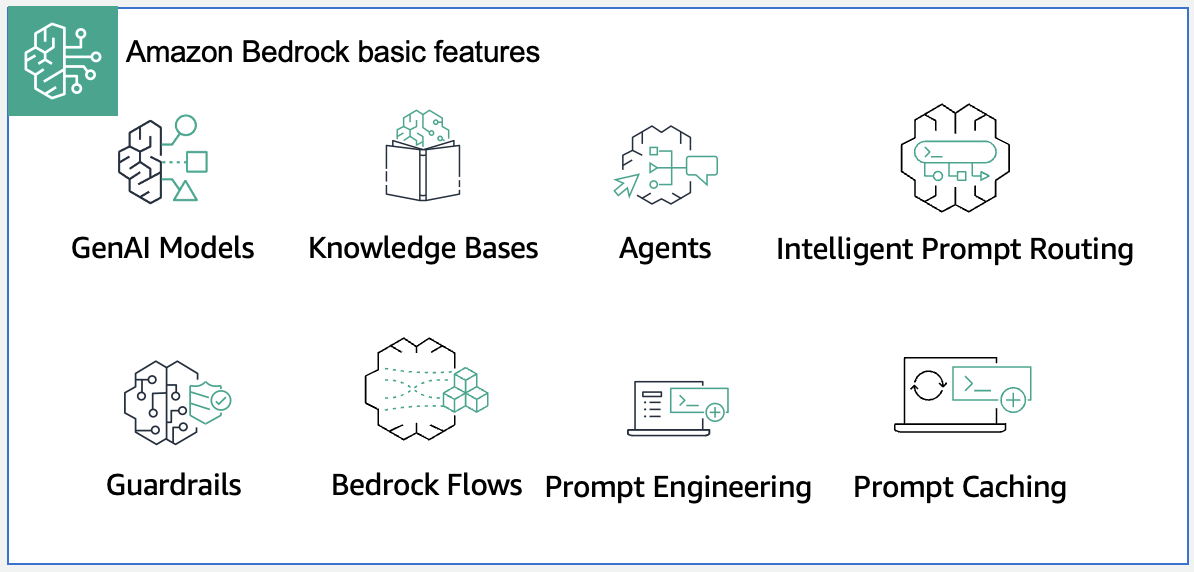
Passo 1: Gerenciar dados para aplicações de IA generativa — Dados servem três funções críticas: potencializar sistemas de Retrieval Augmented Generation (RAG), fornecer verdade fundamental para avaliação de modelos e viabilizar treinamento e ajuste fino. Com Amazon Bedrock, você pode consultar banco de dados de vetores como Amazon OpenSearch Service ou usar Amazon Bedrock Knowledge Bases, uma capacidade gerenciada que implementa todo o fluxo RAG sem integrações customizadas. Configure guardrails para bloquear informações pessoais identificáveis (PII) que não devem ser enviadas ao modelo.
Passo 2: Estabelecer ambiente de desenvolvimento — Integre FMs e capacidades de IA generativa durante prototipagem em desenvolvimento. Use Amazon Bedrock Prompt Management para criar, testar, gerenciar e otimizar prompts. Use Amazon Bedrock Flows para fluxos multietapas como pipelines de análise de documentos. Configure Amazon Bedrock Guardrails para controles de segurança.
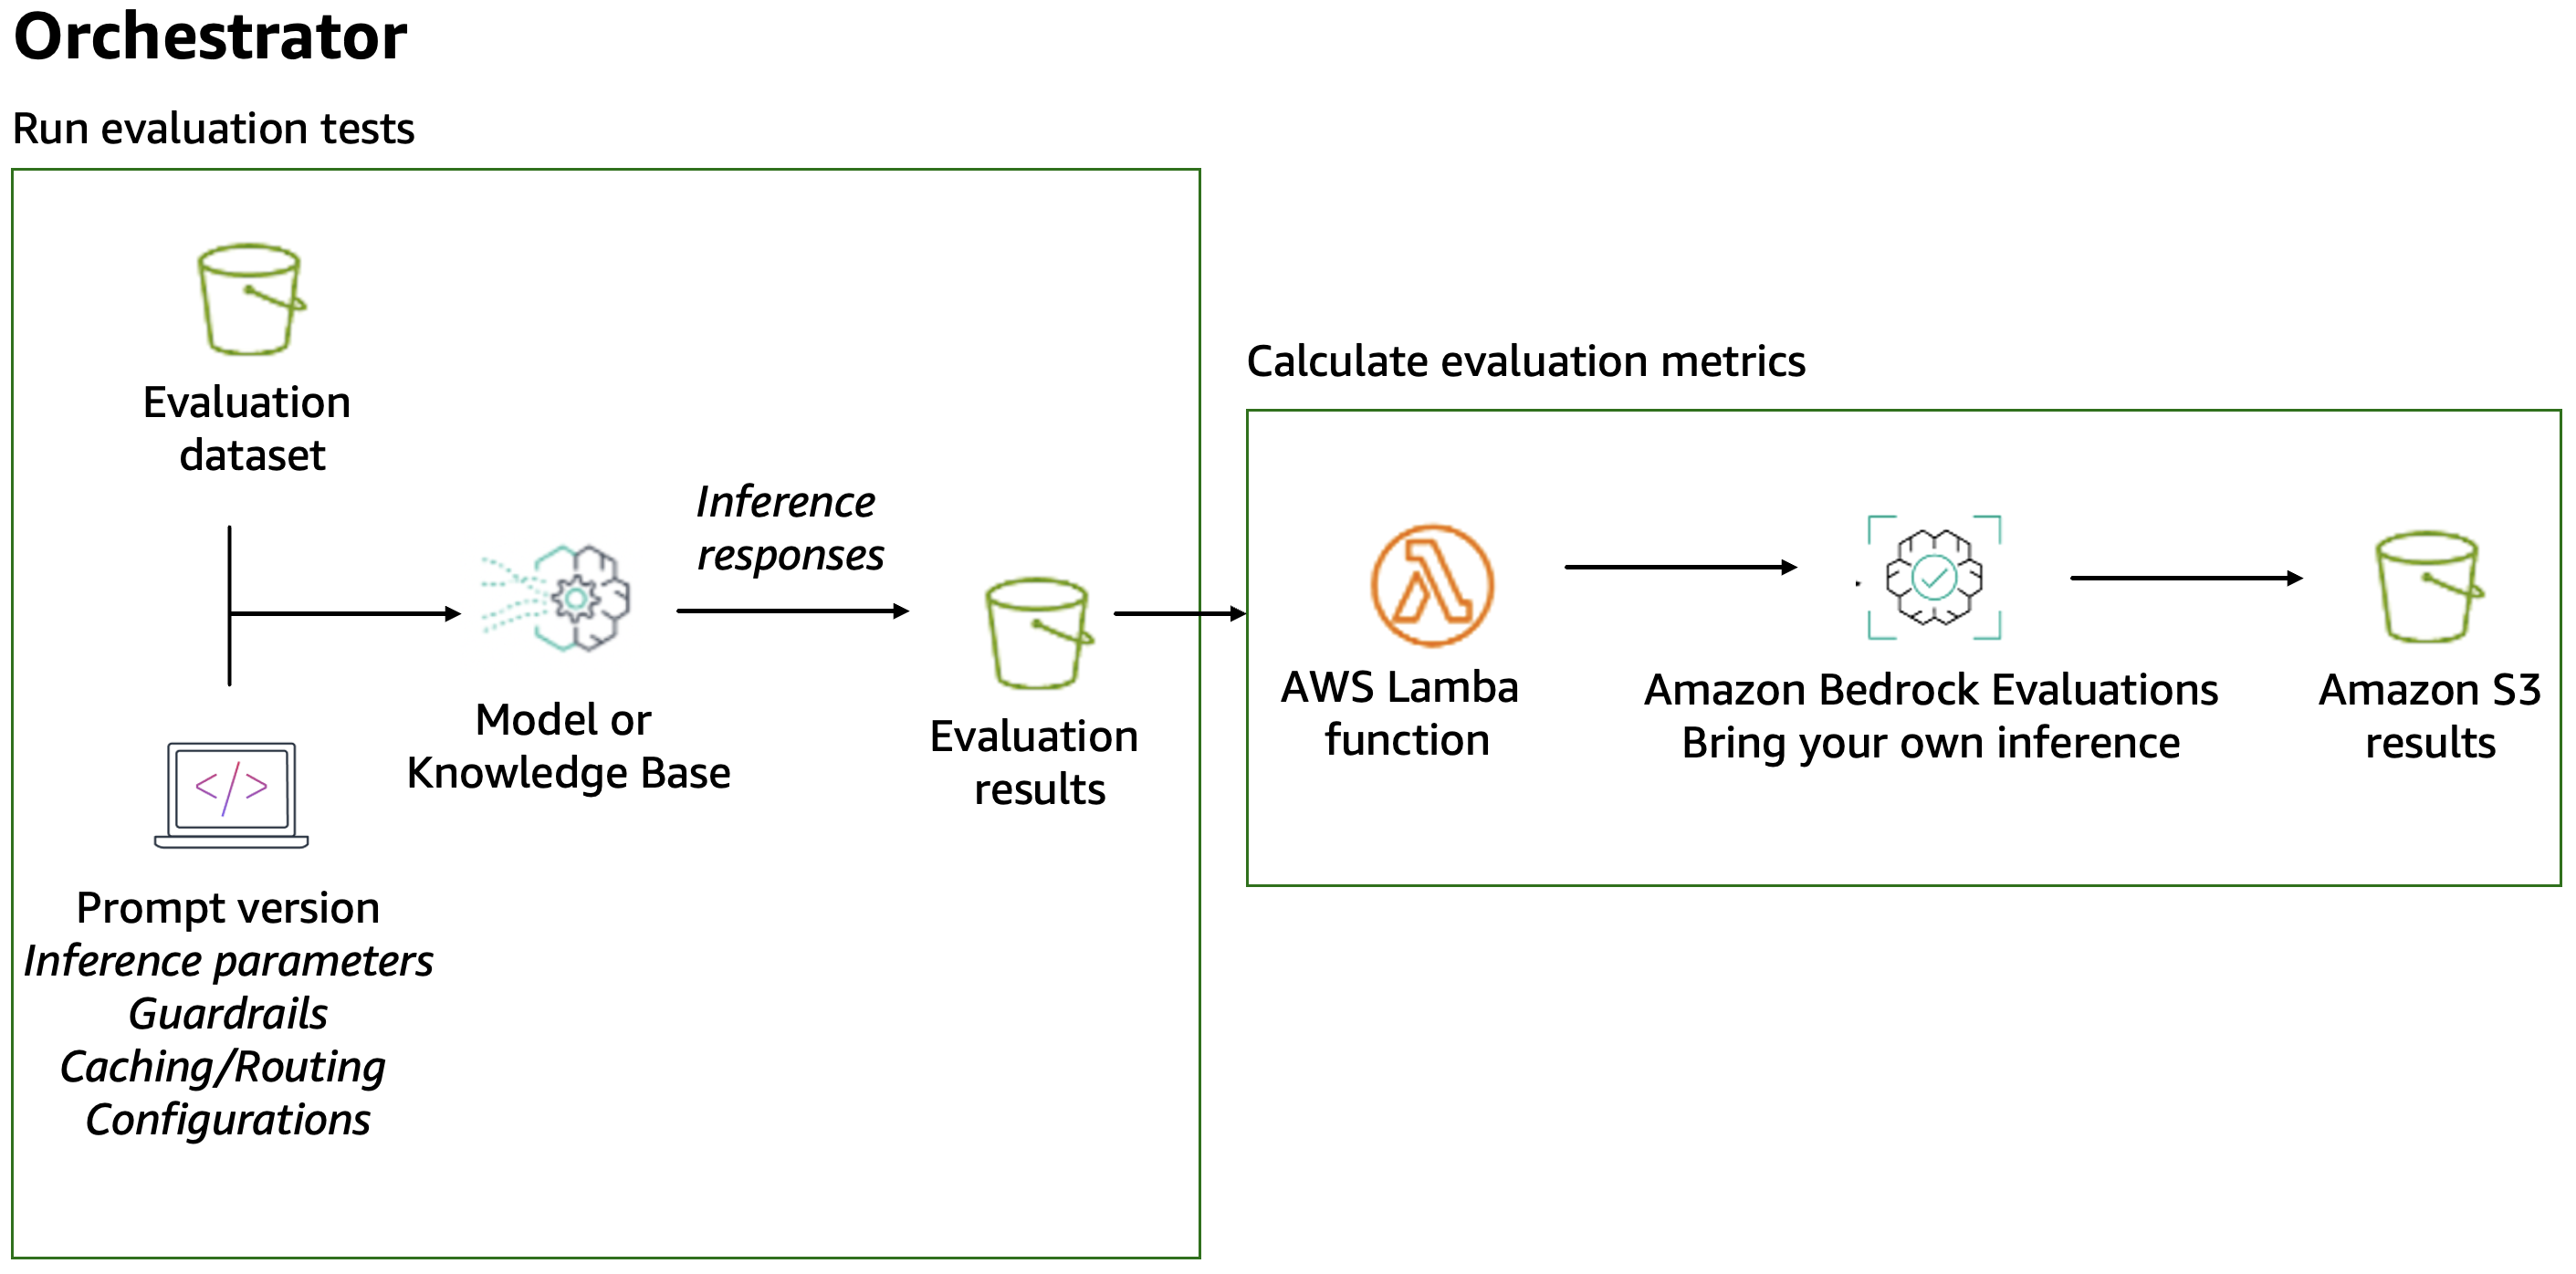
Passo 4: Adicionar testes de IA ao pipeline CI/CD — Após identificar modelo, prompts e configurações ótimos, faça commit ao repositório de aplicação para ativar o pipeline CI/CD. O pipeline deve executar testes de avaliação predefinidos como portão de qualidade essencial. Quando testes passam nos limites de acurácia, segurança e desempenho, o pipeline implanta em pré-produção para validação final.
Passo 5: Monitorar solução de IA generativa — Com observabilidade de IA generativa, ganhe visibilidade para equilibrar custo, desempenho e latência. Monitore métricas operacionais (saúde do sistema, latência de aplicação com breakdown para operações de recuperação, inferência de modelo, uso de tokens), exceções de runtime (rate limiting, excedência de quotas de token), métricas de qualidade (relevância, correção, coerência de resposta), auditoria (logs de interações do usuário) e guardrails (tentativas de injeção de prompt, vazamento de PII).
Conforme as organizações entram no estágio de produção, estabelecem centros de excelência de IA generativa com papéis especializados: engenheiros de prompt, especialistas em avaliação de IA e engenheiros GenAIOps. Treinamento sistemático é implantado, conformidade transita para automação política, e colaboração move-se de coordenação informal para fluxos estruturados com handoffs definidos.
Padronizar repositórios de código e componentes reutilizáveis: Crie blueprints versionados e reutilizáveis para prompts, configuração de modelos e guardrails. Um template de prompt inclui variáveis substituíveis para acelerar engenharia de prompt. Armazene centralmente templates de prompt em catálogo. Para ferramentas de otimização, Prompt optimization in Amazon Bedrock ajuda refinar prompts. Armazene fluxos end-to-end como código no repositório para rastreamento de versão e implantação contínua.
Avaliação automatizada e loops de feedback: Armazene pipelines de avaliação como ativos compartilhados e deployáveis mantidos e versionados em repositório. Para avaliações que incluem revisão humana, use human-based model evaluation em Amazon Bedrock para orquestrar fluxos de avaliação humana.
Muitas organizações progridem de aplicações iniciais com LLM e implementações RAG para arquiteturas sofisticadas baseadas em agentes. Um agente de IA é um sistema autônomo que combina LLMs com ferramentas e fontes de dados externas para perceber seu ambiente, raciocinar, planejar e executar tarefas multietapas complexas com mínima intervenção humana.
A natureza probabilística de alguns componentes traz novos desafios. AgentOps estende GenAIOps para endereçar esses desafios, sendo tema de parte 2 desta série, que mergulha em AgentOps e designs de solução para sistemas multi-agente com Amazon Bedrock AgentCore.
Conclusão
Implementar GenAIOps alinha-se com o estágio de adoção de IA generativa de sua organização, acelera desenvolvimento através de avaliação sistemática e ativos reutilizáveis, e estabelece monitoramento robusto para soluções de IA generativa. Ao aplicar essas práticas, você mitiga riscos e maximiza valor empresarial com as capacidades gerenciadas do Amazon Bedrock.
Entendendo os ataques à cadeia de suprimentos de software
A segurança de cadeias de suprimentos de software é uma prioridade crítica para organizações de todos os tamanhos. Nos últimos meses de 2025, a indústria de segurança testemunhou campanhas coordenadas de ameaças visando repositórios de terceiros, evidenciando vulnerabilidades em como confiamos e consumimos dependências de código aberto. A resposta da AWS a esses eventos revela práticas valiosas de detecção, resposta e aprendizado contínuo.
Entre agosto e dezembro de 2025, a AWS identificou e respondeu a diversas campanhas significativas. A importância dessas respostas reside não apenas na proteção imediata, mas na absorção de conhecimento que alimenta melhorias nos mecanismos de detecção e nas plataformas de segurança disponibilizadas aos clientes. Um dos eventos mais notáveis envolveu mais de 150.000 pacotes maliciosos detectados pelo Amazon Inspector em uma única campanha.
O incidente Nx e a exploração de ferramentas de IA generativa
Detecção e resposta rápida
Em finais de agosto de 2025, padrões anormais em execuções de prompts de IA generativa em softwares de terceiros acionaram escalações imediatas nos times de resposta a incidentes da AWS. Dentro de 30 minutos, um comando de incidente de segurança foi estabelecido, coordenando investigadores em todo o globo.
A investigação revelou a presença de um arquivo JavaScript denominado “telemetry.js” em um popular pacote npm chamado Nx. Este arquivo foi comprometido e projetado para explorar ferramentas de linha de comando de IA generativa. Os atacantes buscavam roubar arquivos de configuração sensíveis através do GitHub, mas falharam em gerar tokens de acesso válidos, impedindo exfiltração de dados.
Metodologia de resposta e melhorias implementadas
A resposta seguiu um processo estruturado e metódico:
Realização de uma avaliação abrangente de impacto em serviços e infraestrutura AWS, mapeando o escopo do incidente;
Implementação de bloqueios em nível de repositório para pacotes npm comprometidos;
Investigação profunda para identificar recursos potencialmente afetados e vetores de ataque alternativos;
Investigação, análise e remediação de hosts afetados;
Incorporação dos aprendizados em Amazon Q, incluindo novas barreiras de segurança em prompts de sistema para rejeitar tentativas de coleta de credenciais, correções para evitar extração de prompts de sistema, e endurecimento adicional em modos de execução de alto privilégio.
Esses aprendizados foram fundamentais para detectar e responder efetivamente a campanhas subsequentes. A AWS refinou como monitora anomalias comportamentais e correlaciona múltiplas fontes de inteligência de ameaças, criando uma base mais robusta de detecção.
Os worms Shai-Hulud e outras campanhas de comprometimento
Propagação em cascata através de pacotes confiáveis
Apenas três semanas após o incidente Nx, em início de setembro de 2025, duas novas campanhas npm emergiram. A primeira direcionou 18 pacotes populares como Chalk e Debug. A segunda, apelidada “Shai-Hulud”, alvo 180 pacotes em sua primeira onda, com uma segunda onda ocorrendo em finais de novembro de 2025.
O worm Shai-Hulud buscava especificamente tokens npm, tokens de acesso pessoal do GitHub e credenciais de nuvem. Quando tokens npm eram obtidos, o worm ampliava seu alcance publicando pacotes infectados como atualizações em repositórios que esses tokens possuíam acesso no registro npm. Cada vez que novos usuários baixavam esses pacotes comprometidos, scripts de pós-instalação executavam o worm, propagando continuamente a infecção.
Além disso, o malware tentava manipular repositórios GitHub para implantar workflows maliciosos, mantendo sua presença em ambientes já infectados.
Resposta coordenada da comunidade de segurança
A resposta da AWS iniciou dentro de 7 minutos após a publicação dos pacotes afetados. As ações incluíram:
Monitoramento contínuo para detectar comportamentos anômalos, com notificações imediatas aos clientes afetados via Painel de Saúde Pessoal AWS, casos de suporte e emails diretos aos contatos de segurança;
Análise dos pacotes npm comprometidos para entender completamente as capacidades do worm, incluindo desenvolvimento de scripts de detonação customizados utilizando IA generativa, executados em ambientes sandbox controlados;
Análise de código JavaScript ofuscado com auxílio de IA para expandir indicadores conhecidos e pacotes afetados.
Esse trabalho revelou os métodos utilizados pelo malware para direcionamento de tokens GitHub, credenciais AWS, credenciais Google Cloud, tokens npm e variáveis de ambiente. Melhorando como anomalias consistentes com roubo de credenciais são detectadas, analisando padrões no repositório npm e correlacionando contra múltiplas fontes de inteligência, a AWS construiu compreensão mais profunda dessas campanhas coordenadas.
Saiba mais sobre como os sistemas de detecção do Amazon Inspector identificaram esses pacotes e como trabalham com a OpenSSF para ajudar a comunidade de segurança.
A campanha de roubo de tokens tea[.]xyz
Escala massiva de comprometimento
Entre finais de outubro e início de novembro de 2025, técnicas refinadas pelo time do Amazon Inspector detectaram um aumento em pacotes npm comprometidos. O sistema descobriu uma nova onda direcionada aos tokens Tea, utilizados para reconhecer contribuições em projetos de código aberto. O time identificou 150.000 pacotes comprometidos durante essa campanha.
A resposta foi notavelmente ágil: em cada detecção, a equipe conseguiu registrar automaticamente o pacote malicioso no registro de pacotes maliciosos da OpenSSF dentro de 30 minutos. Essa velocidade não apenas protegeu clientes utilizando Amazon Inspector, como permitiu que a comunidade mais ampla de segurança protegesse seus ambientes com base nesses dados compartilhados.
Aprendizado contínuo e adaptação
Cada detecção trouxe novas compreensões que foram incorporadas no processo de resposta a incidentes e melhorias contínuas nas detecções. O alvo único dessa campanha — tokens tea[.]xyz — forneceu um novo vetor para refinar as proteções implementadas pelos diversos times de segurança da AWS.
Novas ameaças emergentes e padrões comuns
Conforme este artigo era finalizado em dezembro de 2025, uma nova onda de atividade foi detectada, direcionando pacotes npm. Designada como “elf-“, essa onda foi projetada para roubar dados sensíveis de sistema e credenciais de autenticação. Quase 1.000 pacotes suspeitos foram identificados no registro npm ao longo de uma semana. Mecanismos de defesa automatizados identificaram rapidamente esses pacotes e reportaram à OpenSSF.
Através dessas experiências, padrões comuns emergiram: exploração de relacionamentos de confiança dentro da rede de código aberto, operação em escala massiva, coleta de credenciais e acesso não autorizado a segredos, e técnicas aprimoradas para evadir controles de segurança tradicionais.
Estratégias para proteger sua organização
Monitoramento contínuo e detecção aprimorada
Implementar monitoramento ininterrupto e detecções aprimoradas para identificar padrões incomuns é fundamental. Essa abordagem permite identificação de ameaças em estágios iniciais, antes que possam causar danos significativos. Serviços como o AWS Security Hub fornecem visão abrangente do ambiente em nuvem, achados de segurança e verificações de conformidade, permitindo que organizações respondam em escala.
Auditoria periódica e validação de cobertura
Periodicamente auditar a cobertura de ferramentas de segurança comparando resultados contra múltiplas fontes autoritativas ajuda a identificar gaps. O Amazon Inspector pode auxiliar no monitoramento contínuo da cadeia de suprimentos de software.
Proteção em camadas
Adotar abordagens multicamadas de proteção é essencial:
Controles de rede para prevenir exfiltração de dados (exemplo: AWS Network Firewall).
Inventário abrangente de dependências
Manter inventário completo de todas as dependências de código aberto, incluindo dependências transitivas e localizações de implantação, permite resposta rápida quando ameaças são identificadas. Serviços como Amazon Elastic Container Registry (ECR) auxiliam com varredura automática de containers para identificar vulnerabilidades. O AWS Systems Manager pode ser configurado para atender objetivos de segurança e conformidade.
Compartilhamento de inteligência de ameaças
Reportar pacotes suspeitos a mantenedores, compartilhar inteligência de ameaças com grupos da indústria e participar em iniciativas que fortaleçam defesa coletiva amplifica o impacto da proteção. Consulte a página de Boletins de Segurança AWS para informações sobre boletins recentemente publicados.
Resposta proativa e pesquisa coordenada
Implementar pesquisa proativa, investigação abrangente e resposta coordenada, combinando ferramentas de segurança, especialistas técnicos e procedimentos de resposta praticados, fortalece significativamente a postura defensiva. O AWS Security Incident Response oferece esse tipo de abordagem estruturada.
Conclusão: a evolução contínua de ameaças e defesas
Ataques à cadeia de suprimentos continuam evoluindo em sofisticação e escala. Os exemplos descritos neste artigo demonstram essa progressão. As lições extraídas desses eventos reforçam a importância crítica de implementar controles de segurança em camadas, manter monitoramento contínuo e participar em esforços colaborativos de defesa.
À medida que essas ameaças continuam evoluindo, a AWS continua fornecendo proteção contínua aos clientes através de abordagem de segurança abrangente. O compromisso com aprendizado contínuo busca melhorar práticas internas, auxiliar clientes e fortalecer a comunidade global de segurança.